GEO — это не новый раздел маркетинга с отдельным бюджетом. Это несколько конкретных технических штук, которые я уже сделал на своём сайте, и сейчас покажу, как именно.
6 мин чтения
GEO-оптимизация сайта: как попасть в ответы нейросетей
Разбираю GEO без теории: как настроить robots.txt, llms.txt и JSON-LD так, чтобы ChatGPT, Яндекс Нейро и Perplexity реально цитировали ваш сайт, а не игнорировали его.
- 01 GEO — это не другая вселенная, а расширение SEO
- 02 Кто и как решает, кого цитировать
- 03 Не блокируйте роботов, которых сами хотите видеть
- 04 llms.txt: короткая шпаргалка для краулера
- 05 JSON-LD: как объяснить нейросети, кто вы
- 06 Bing Webmaster Tools — незаметный, но обязательный шаг
- 07 Мониторинг: как узнать, что вас правда цитируют
- 08 Чек-лист: готов ли сайт к тому, чтобы его цитировали
GEO — это не другая вселенная, а расширение SEO
Забавно, но большинство статей про GEO (Generative Engine Optimization) пересказывают одно и то же: «нейросети — это новый канал трафика, срочно оптимизируйтесь». А что конкретно делать — молчок.
У меня на этот счёт мнение простое: 90% GEO — это SEO-гигиена, которую я и так соблюдаю с 2016 года. Структура, понятный первый абзац, микроразметка, доступность для роботов. Всё остальное — надстройка. Оставшиеся 10% — три вещи, которых раньше не было: файл llms.txt, отдельный мониторинг цитируемости и необходимость пускать к себе краулеров, о которых пять лет назад никто не слышал.
Мы все привыкли, что поисковик хочет структурированный, понятный текст — теперь того же самого хочет ещё и нейросеть, просто под другим именем.
GEO — не новая наука с нуля. Это те же правила понятности, которые я соблюдал ради SEO. Просто теперь их читает не только Яндекс, но и ChatGPT.
Игорь Петров
Если разбираетесь, какие ИИ-инструменты вообще стоит тащить в бизнес, — я отдельно писал про это в статье «Лучшие ИИ для бизнеса в 2026». Здесь — только про сайт и про то, как сделать его видимым для этих инструментов.
Кто и как решает, кого цитировать
Тут не один механизм, а минимум три разных, и они не похожи друг на друга.
Яндекс Нейро и Алиса сначала ищут кандидатов в обычной выдаче — берут топ-20 по запросу — и только потом отбирают из них 3–7 источников для ответа. Без топ-20 — никак. Позиций в обычном поиске нет — сайт вообще не попадёт в рассмотрение, какая бы идеальная микроразметка на нём ни стояла.
Неожиданно, но факт
Нейро не «обходит» классический поиск — он строится поверх него. Сначала нужен топ-20 по теме, и только потом в игру вступают структура и разметка.
ChatGPT Search и Microsoft Copilot устроены иначе: они берут данные из индекса Bing. Если сайта нет в Bing — про него ChatGPT не расскажет, сколько бы качественного контента там ни было. Отдельного «индекса ChatGPT» не существует, есть только чужой индекс, который он использует.
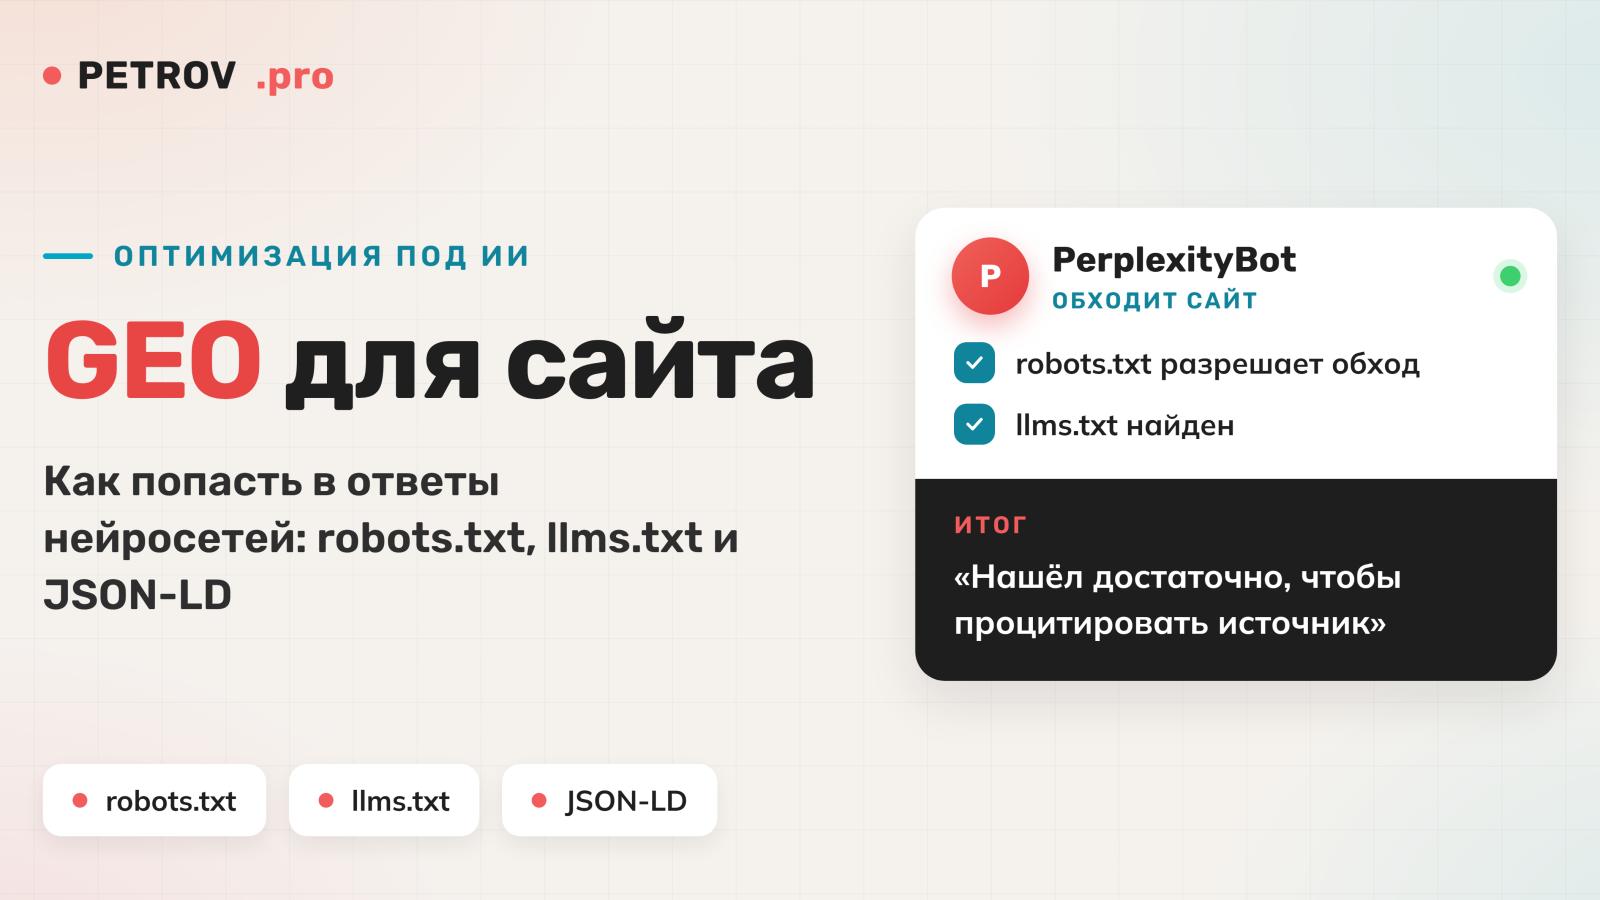
Perplexity ближе всего к классическому краулеру: у него свой бот (PerplexityBot) и собственный веб-поиск в реальном времени. Если бот не заблокирован в robots.txt — у него есть шанс дойти до страницы и процитировать её прямо сейчас, без ожидания переиндексации.
| Что важно | Яндекс Нейро / Алиса | ChatGPT Search / Copilot | Perplexity |
|---|---|---|---|
| Откуда берёт источники | Из топ-20 обычной выдачи, дальше отбор 3–7 сайтов | Из индекса Bing — без него цитат не будет | Собственный краулер + веб-поиск в реальном времени |
| Что обязательно | Позиции в поиске + чёткий ответ в тексте | Сайт подтверждён в Bing Webmaster Tools, есть sitemap | PerplexityBot не заблокирован в robots.txt |
| Где смотреть цитируемость | Яндекс.Вебмастер → Эффективность → «Видимость в Алисе ИИ» | Bing Webmaster → отчёт по AI-performance | Руками: спросить напрямую и посмотреть на ссылки в ответе |
Не блокируйте роботов, которых сами хотите видеть
Первая и самая обидная ошибка — где-то в старом robots.txt висит Disallow: / для всех ботов подряд, поставленный три года назад «на всякий случай». А потом человек удивляется, почему ИИ его не находит.
У меня в robots.txt нет ни одной строчки, блокирующей краулеры нейросетей — ни GPTBot (OpenAI), ни ClaudeBot (Anthropic), ни PerplexityBot, ни YandexAdditionalBot (краулер, который Яндекс использует для Нейро и быстрых ответов). Единственное правило — Clean-param для Яндекса, чтобы не плодить дубли из-за UTM-меток, и ссылка на sitemap.xml. Всё. Проверьте свой файл ровно на это: не «правильно ли составлен robots.txt» вообще, а нет ли там случайного бана для четырёх конкретных user-agent'ов.
llms.txt: короткая шпаргалка для краулера
llms.txt — текстовый файл в корне сайта (/llms.txt), который в человекочитаемом markdown коротко объясняет краулеру, кто вы и что у вас на сайте. Не разметка, не мета-тег — обычный текстовый файл, который может открыть и человек, и бот.
У меня он выглядит примерно так: короткое описание в один абзац («разработка чат-ботов и сайтов с ИИ, работает лично Игорь Петров»), список услуг со ссылками и ценами, список статей блога, ссылка на контакты. Никакой магии. Смысл простой: экономлю краулеру время на то, чтобы «понять» сайт, вместо того чтобы он сам пытался это вычислить по разметке страниц.
Не продавайте себе миф
llms.txt — предложенный формат, а не подтверждённый сигнал ранжирования ни у OpenAI, ни у Google, ни у Яндекса. Ставьте его ради порядка и экономии токенов краулера, но не ждите, что один файл заменит нормальную структуру сайта.
Как собрать такой файл по шагам, какие разделы обязательны и чем он отличается от sitemap.xml — я разобрал отдельно в статье «llms.txt: зачем сайту файл для ИИ-краулеров».
JSON-LD: как объяснить нейросети, кто вы
Вот тут начинается настоящая работа, а не текстовый файлик на пять минут. Тут без разметки уже не обойтись.
JSON-LD — это разметка Schema.org в <script type="application/ld+json">, которая явно говорит роботу: вот это — статья, вот это — автор, вот это — организация, вот это — цена услуги. Без разметки робот тоже может догадаться по контексту (LLM в этом неплохи), но с разметкой ему не нужно гадать вообще.
На своём сайте я держу три слоя разметки одновременно:
- Person + Organization — единая сущность «Игорь Петров / iPetrov.pro» с
@id, привязанным к главной странице. Она подключена и на блоге, и потенциально на любой другой странице, а Google с Яндексом дедуплицируют её по@id, не плодя два разных «автора». - BlogPosting — на каждой статье блога: заголовок, автор, издатель, дата публикации и правки, категория.
- Service + Offer + FAQPage — на страницах услуг: что делаю, сколько стоит, какие вопросы мне обычно задают.
Если честно, сделал это не с первого дня. Сначала на блоге появился только BlogPosting, а сущность автора Person+Organization добавил позже — заметил, что без единого @id разные системы видят «ИП Петров» и «iPetrov.pro» как двух разных, никак не связанных персонажей. Для «Оригами» (алгоритм Яндекса, который требует верифицируемого автора) это прямой минус.
Пример упрощённо — так выглядит связка автора и организации:
{
  "@context": "https://schema.org",
  "@graph": [
    { "@type": "Person", "@id": "https://ipetrov.pro/#person", "name": "Игорь Петров" },
    { "@type": "Organization", "@id": "https://ipetrov.pro/#organization", "name": "iPetrov.pro",
      "founder": { "@id": "https://ipetrov.pro/#person" } }
  ]
}
В базовый пакет Разработка сайта под ключ от 50 000 ₽ у меня уже входит SEO-база — та самая Schema.org-разметка и Метрика с целями. Без неё JSON-LD ставить особо не на что: сначала нужна внятная структура страницы, а уже потом разметка её описывает.
Какие типы разметки бывают, где брать готовые шаблоны и как проверить их валидатором — подробный разбор с примерами я вынес в отдельную статью про микроразметку Schema.org.
Bing Webmaster Tools — незаметный, но обязательный шаг
Вот пункт, который почти все пропускают, потому что звучит как архаика из 2012 года. А зря.
ChatGPT Search и Microsoft Copilot берут ответы из индекса Bing. Не из своего собственного — из чужого. Значит, если сайта нет в Bing, ChatGPT физически не может его процитировать, сколько бы у вас ни было качественного контента и правильного JSON-LD, — и это правило, о котором почему-то почти никто не пишет в статьях про GEO, хотя оно важнее любой микроразметки. Регистрация в Bing Webmaster Tools занимает минут пять: сайт можно импортировать прямо из Google Search Console, без отдельной верификации. Дальше — отправить sitemap.xml, и через IndexNow новые страницы попадают в индекс за часы, а не за недели ожидания обычного краулера.
Кстати, у меня был момент, когда я пару месяцев — вернее, ближе к трём — вообще не заходил в этот кабинет: не до того было, шёл проект. GEO не развалилось за это время, но и новые статьи в ответах ИИ-поиска попросту не появлялись. Совпадение? Не думаю.
Мониторинг: как узнать, что вас правда цитируют
Самая скучная, но самая важная часть — это не настройка, а проверка. Без неё вы никогда не узнаете, работает GEO или вы просто поставили файлы для красоты.
Три рабочих способа, которыми пользуюсь сам:
Первый — раздел «Видимость сайта в Алисе ИИ» в Яндекс.Вебмастере (Эффективность → Видимость в Алисе ИИ). Он показывает примеры запросов, по которым Алиса уже цитирует сайт как источник, и данные обновляются раз в неделю. Статистика собирается только по тем запросам, где сайт и так неплохо ранжируется в обычном поиске — вернёмся к тому же тезису про топ-20.
Второй — отчёт по AI-performance в Bing Webmaster Tools, который появляется после индексации и показывает попадания в Copilot. Тоже полезно.
Третий, самый честный — просто спросить руками. Точнее, не совсем просто, а муторно, зато достовернее любого дашборда. Раз в месяц я задаю ChatGPT, Perplexity и Алисе вопросы из своей ниши и смотрю на ссылки в ответе. Как-то раз в ответе Perplexity на вопрос про чат-ботов с ИИ всплыла конкретная статья блога про RAG — не главная страница, не лендинг, а именно кусок контента, который прямо отвечал на вопрос. Это лучше любой аналитики объясняет, зачем структурировать текст: нейросети цитируют не «сайт вообще», а конкретный абзац с конкретным ответом.
Подробнее про то, как собрать «Видимость в Алисе ИИ» в идеи для контента, писали коллеги из индустрии — механика описана честно, без прикрас.
Чек-лист: готов ли сайт к тому, чтобы его цитировали
GEO-готовность сайта
7 вопросов на 5 минут
- В robots.txt нет Disallow ни для одного ИИ-краулера (GPTBot, ClaudeBot, PerplexityBot, YandexAdditionalBot)
- На сайте есть llms.txt со ссылками на реальные услуги и статьи
- На страницах стоит JSON-LD Person/Organization с единым @id
- Каждая статья блога размечена как BlogPosting с датой публикации
- Сайт подтверждён в Bing Webmaster Tools и туда отправлен sitemap
- Первый абзац ключевых страниц прямо отвечает на вопрос, а не начинается с воды
- Раз в месяц проверяете видимость в «Алисе ИИ» или руками через ChatGPT/Perplexity
/
Мне кажется, GEO пугает именно потому, что звучит как отдельная профессия. На деле это семь пунктов из списка выше, из которых половину вы, скорее всего, уже закрыли ради обычного SEO. Осталось не полениться дособрать остальное.
Хотите, чтобы ваш сайт цитировали нейросети?
Проверю robots.txt, JSON-LD и llms.txt вашего сайта и скажу честно, что чинить в первую очередь. Бесплатно, 15 минут.